“我和聊天机器人对话,AI公司员工也能看到?”
个人信息保护委员会向6家AI企业发出整改建议
AI训练数据含居民登记号等信息
“人工审核流程须向用户明确告知”

韩国政府向包括OpenAI、谷歌、Naver在内、提供人工智能(AI)服务的6家大型语言模型(LLM)企业发出了大规模整改建议。

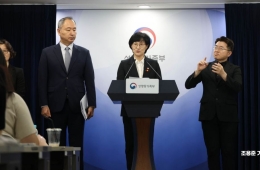
个人信息保护委员会27日召开全体会议,决定向6家开发、发布LLM或基于LLM提供AI服务的经营者发出整改建议,要求其弥补个人信息保护方面的薄弱环节。被建议整改的企业为OpenAI、谷歌、微软(Microsoft)、Meta、Naver和Ruitn Technologies。
个人信息保护委员会表示,随着AI服务的扩散,对隐私侵害的担忧日益加剧,自去年11月起,已与韩国互联网振兴院联合开展了事前实态检查。检查结果显示,各企业大体上满足了《个人信息保护法》上的基本要求,但在▲AI学习数据中所含个人信息的处理 ▲通过人工审核过程造成的隐私侵害 ▲预防和应对个人信息侵害的措施及透明度等方面,仍发现部分不足之处。
首先发现,AI随机学习的数据中,可能包含居民登记号、信用卡号等重要个人信息。就OpenAI、谷歌、Meta等LLM开发企业而言,经确认,它们在学习数据中预先删除此类主要识别信息的措施尚不充分。
个人信息保护委员会在要求强化AI服务各阶段的保护措施的同时,还决定向企业提供发现我国国民个人信息在互联网泄露时所探测到的相关网址(URL)。

AI 服务注册时,为人工智能研究等目的提供的使用说明,以及对话输入界面中标注“由人工审核员处理(processed by human reviewer)”的提示示例
View original image此外,个人信息保护委员会建议,明确告知用户,其与AI聊天机器人之间的对话内容有可能由人工直接审核。个人信息保护委员会解释称:“基于LLM提供AI服务的经营者,为了让AI模型给出准确答案,正在投入大量审核人员,直接阅览、审查问答内容以构建数据集”,“并确认这些数据被用于AI模型学习及提示词等服务改进”。
但从用户角度来看,很难知晓自己输入的数据会经过人工审核,而且用户有可能输入重要个人信息或电子邮件等,因此存在引发隐私侵害的风险。个人信息保护委员会建议提高相关功能的可达性,使用户能够便捷地删除自己输入的数据。
最后,经确认,即便是基于同一LLM的AI服务,在针对个人信息和敏感信息的回答等方面,所采取的侵害预防措施程度也存在差异。个人信息保护委员会还建议各企业建立起在发现AI服务或LLM存在漏洞时能够迅速采取措施的处理流程。
个人信息保护委员会相关负责人表示,将“根据AI产业的变化,持续开展监测,以确保能够安全保护信息主体的个人信息”,并称“计划推进制定AI指引、开发强化个人信息保护技术等后续措施”。Naver方面表示:“今后也将与个人信息保护委员会紧密合作,把用户个人信息保护放在首位提供服务。”
版权所有 © 阿视亚经济。未经许可不得转载,禁止用于AI训练及使用。